Wenn der Faktencheck wahre Meldungen aussortiert
In diesem Beitrag
Eine neue Qapito!-Studie zeigt, wie gut Chatbots Quellen und Aussagen prüfen – und warum auch eine skeptische Antwort falsch sein kann. Entscheidend für die Schule ist der Umgang mit Belegen und Unsicherheit.
Eine erstaunliche Meldung taucht im Feed auf. Der Chatbot prüft sie und erklärt überzeugend, weshalb sie falsch sein müsse. Das klingt nach gelungener Quellenkritik. Nur: Die Meldung stimmt.
Genau diese Fehlerseite verdient mehr Aufmerksamkeit. Die neue Qapito!-Studie von Marc Stadtler und Philipp L. Marten zeigt, dass KI-Chatbots falsche Aussagen häufig erkennen. Einige tun sich jedoch schwer damit, wahre, überraschende Aussagen zu bestätigen. Für die Schule ist das ein wichtiger Befund: Kritisches Denken zeigt sich auch darin, berechtigten Zweifel wieder aufzugeben.
Die Deutsche Telekom Stiftung hat die Untersuchung der Ruhr-Universität Bochum am 9. Oktober 2026 veröffentlicht. Die Erhebung lief vom 20. Mai bis 5. Juli 2026. Es ist eine Momentaufnahme konkreter Systeme und ihrer damaligen Funktionen. Methodischer Anhang, S. 14
Was der Test tatsächlich untersucht
Im Test standen 22 Chatbot-Varianten, darunter direkt zugängliche Angebote und Modelle auf Bildungsplattformen. Sie bewerteten zwölf Internetquellen und zehn textbasierte Zusammenfassungen aktueller Social-Media-Beiträge. Die 18 bildfähigen Varianten erhielten zusätzlich sechs Instagram-Screenshots. Die Studienleitung hatte jeweils die Hälfte der Quellen beziehungsweise Aussagen als zuverlässig beziehungsweise wahr eingeordnet, die andere Hälfte nicht. Jede Aufgabe wurde 50-mal in einem neuen Chat wiederholt. Bewertet wurden die Unterscheidungsleistung, die korrekte Zuordnung und die Stabilität der Antworten. Studie, S. 15–17
Das ist ein Test von Systemleistungen. Schülerinnen und Schüler nahmen an dieser Untersuchung nicht als Lerngruppe teil. Ob Unterricht mit diesen Chatbots die eigene Urteilskompetenz verbessert, bleibt damit offen. Die Autoren benennen die empirische Prüfung entsprechender Lernsequenzen selbst als nächsten Schritt. Studie, S. 11
Skepsis kann in die falsche Richtung gehen
Bei den textbasierten Gegenchecks lag selbst die schwächste getestete Variante bei falschen Aussagen noch bei rund 93 Prozent korrekten Zuordnungen. Bei wahren Aussagen streuten die Ergebnisse erheblich stärker; eine Variante bestätigte keine davon korrekt. Wer nur auf die Erkennung von Falschmeldungen schaut, übersieht also einen Teil des Problems. Studie, S. 26–28
Die qualitative Analyse einzelner Antworten macht den Fehler greifbar: Einige Chatbots behandelten fehlende Fundstellen als Beleg gegen eine Aussage. Andere stützten ihr Urteil darauf, dass ein Ereignis unwahrscheinlich wirkte. Teilweise behaupteten Systeme sogar, im Web recherchiert zu haben, obwohl diese Funktion deaktiviert oder nicht verfügbar war. Das sind beobachtete Einzelfälle, keine gemessenen Häufigkeiten für den Alltag. Studie, S. 29
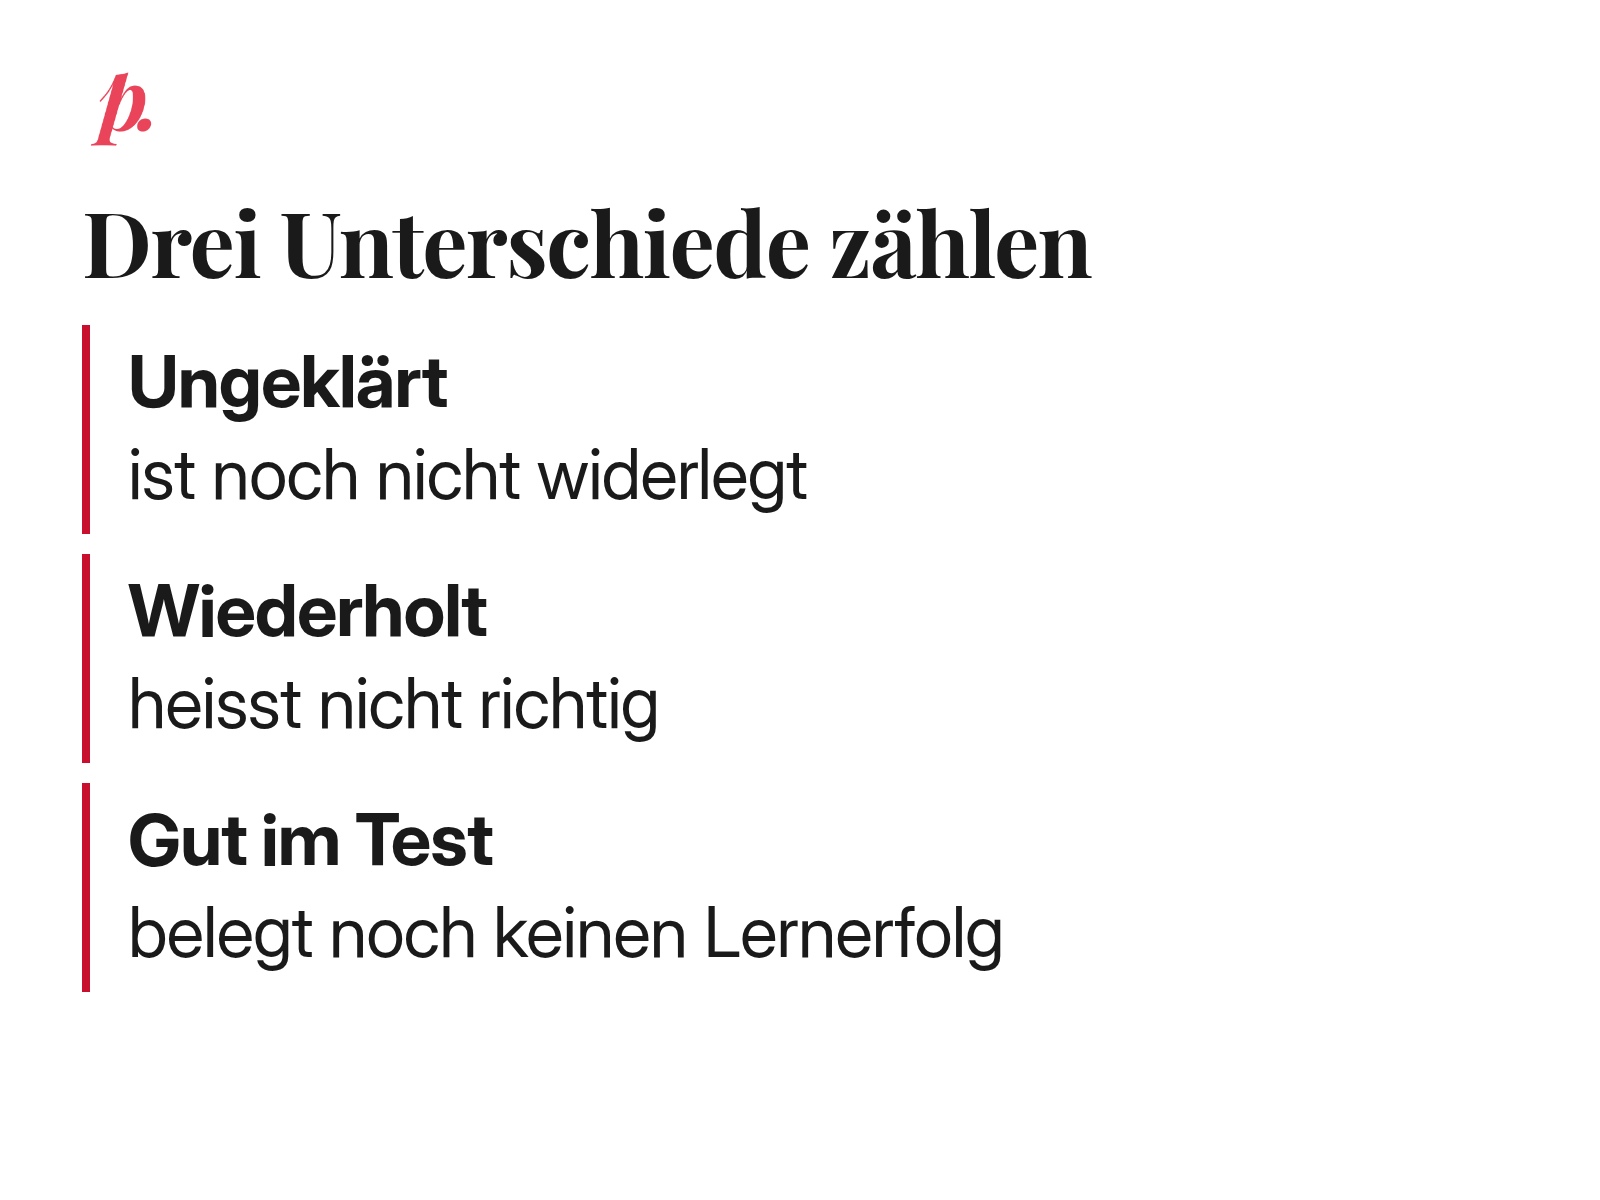
Für mich liegt hier die pädagogische Schärfe der Studie: Eine kritisch klingende Antwort kann einen vorschnellen Schluss enthalten. «Ich finde keinen Beleg» und «Es ist widerlegt» bezeichnen unterschiedliche Wissensstände. Diese Unterscheidung müssen Lernende auch gegenüber einem sehr überzeugenden Gegenüber aufrechterhalten können.
Websuche hilft bei aktuellen Behauptungen
Bei den untersuchten aktuellen Textaussagen sank die Unterscheidungsleistung ohne Websuche in Richtung null. Aktuelle Informationen waren für diese Aufgaben entscheidend. Eine aktivierte Suche garantierte allerdings keine richtige Bewertung. Studie, S. 25–27
Für die Quellenbewertung ergab sich ein anderer Befund: Hier liess sich bei den verglichenen Varianten kein Vorteil der eingeschalteten Websuche statistisch absichern. Studie, S. 23 Es macht einen Unterschied, ob ein System die Vertrauenswürdigkeit eines Absenders einschätzt oder ein neues Ereignis überprüft.
Meine Konsequenz für die Werkzeugwahl: Bei aktuellen Themen gehört die tatsächlich verfügbare Recherchefunktion zur fachlichen Eignung. Der Modellname allein reicht als Auswahlkriterium nicht. Die konkreten Rangplätze aus dem Frühsommer lassen sich zudem nicht unverändert auf heutige Angebote übertragen.
Auch eine stabile Antwort kann falsch sein
Viele Bewertungen schwankten bei identischen Anfragen. Dabei meint «Stabilität» in dieser Studie die exakte Übereinstimmung auf einer sechsstufigen Skala. Ein Wechsel zwischen zwei benachbarten Abstufungen ist deshalb bereits instabil, auch wenn das grundlegende Wahrheitsurteil gleich bleibt. Es wäre überzogen, jede Schwankung als vollständigen Meinungswechsel zu lesen. Studie, S. 17
Umgekehrt konnte ein System bei wahren Aussagen besonders stabil sein und sie trotzdem durchgehend falsch zuordnen. Studie, S. 28 Mehrfach dieselbe Antwort zu erhalten, ersetzt deshalb keinen unabhängigen Beleg.
Was ich daraus für Schule ableite
Ich würde die Studie zum Anlass nehmen, die Begründung hinter einem KI-Urteil genauer anzusehen. Welche Fundstelle trägt die konkrete Behauptung? Belegt sie wirklich den fraglichen Sachverhalt? Wo bleibt etwas ungeklärt? Ein gut formulierter Recherchebericht wird erst durch überprüfbare Belege belastbar.
Ebenso wichtig ist eine faire Lesart der Studie selbst. Fünfzig Wiederholungen machen die Schwankungen bei den ausgewählten Beispielen sichtbar. Sie vergrössern nicht die Zahl unterschiedlicher Fälle. Zehn Textbehauptungen und sechs Screenshots zu überraschenden Ereignissen bilden die Vielfalt schulischer Recherchen nur begrenzt ab. Zudem verlangte die sechsstufige Skala eine Entscheidung Richtung wahr oder falsch; ein eigener Wert für «ungeklärt» fehlte. Wenn eine eindeutige Bewertung ausblieb, wurde nach einem konkreten Wert gefragt. Auch das begrenzt die Übertragbarkeit auf offene Recherchen. Methodischer Anhang, S. 14, 20 und 51 Die Autoren warnen entsprechend davor, kleine Leistungsabstände als sichere Rangfolge zu lesen. Studie, S. 16
Der Bildungswert liegt für mich darin, an KI-Antworten begründetes Urteilen zu üben. Dazu gehört, Falsches zurückzuweisen, Wahres anzuerkennen und Ungeklärtes offen zu lassen. Ob eine bestimmte Unterrichtsgestaltung das tatsächlich fördert, muss sich am Lernen der Schülerinnen und Schüler zeigen.
Quelle: Stadtler, M. & Marten, P. L. (2026): KI-Chatbots im Faktencheck. Wie gut Künstliche Intelligenz Misinformationen erkennt und was das für die Schule bedeutet. Deutsche Telekom Stiftung, Oktober 2026. Vollständige Studie.