Tokens können Zeichen bündeln
Ein Sprachmodell kann einen Text erklären und beim Buchstabenzählen stolpern.
Von Lucca Spohn · 2026-10-20
Das wirkt widersprüchlich. Ein Teil der Erklärung liegt darin, wie der Text beim Modell ankommt: Häufig sind es Wortteile, nicht einzelne Buchstaben. Eine flüssige Antwort sagt deshalb wenig darüber aus, wie zuverlässig das Modell Zeichen zählt oder umsortiert.
Eine neue Nature-Arbeit zeigt einen anderen Ansatz. Die Forschenden rüsten bestehende Sprachmodelle auf die Verarbeitung von Bytes um. Diese Einheiten bilden die technische Textcodierung. Die umgebauten Modelle schneiden bei Aufgaben auf Zeichenebene besser ab; bei breiteren Aufgaben nähern sie sich den Ausgangsmodellen an. Das ist kein Beleg, dass jetzt jedes Modell fehlerfrei buchstabiert.
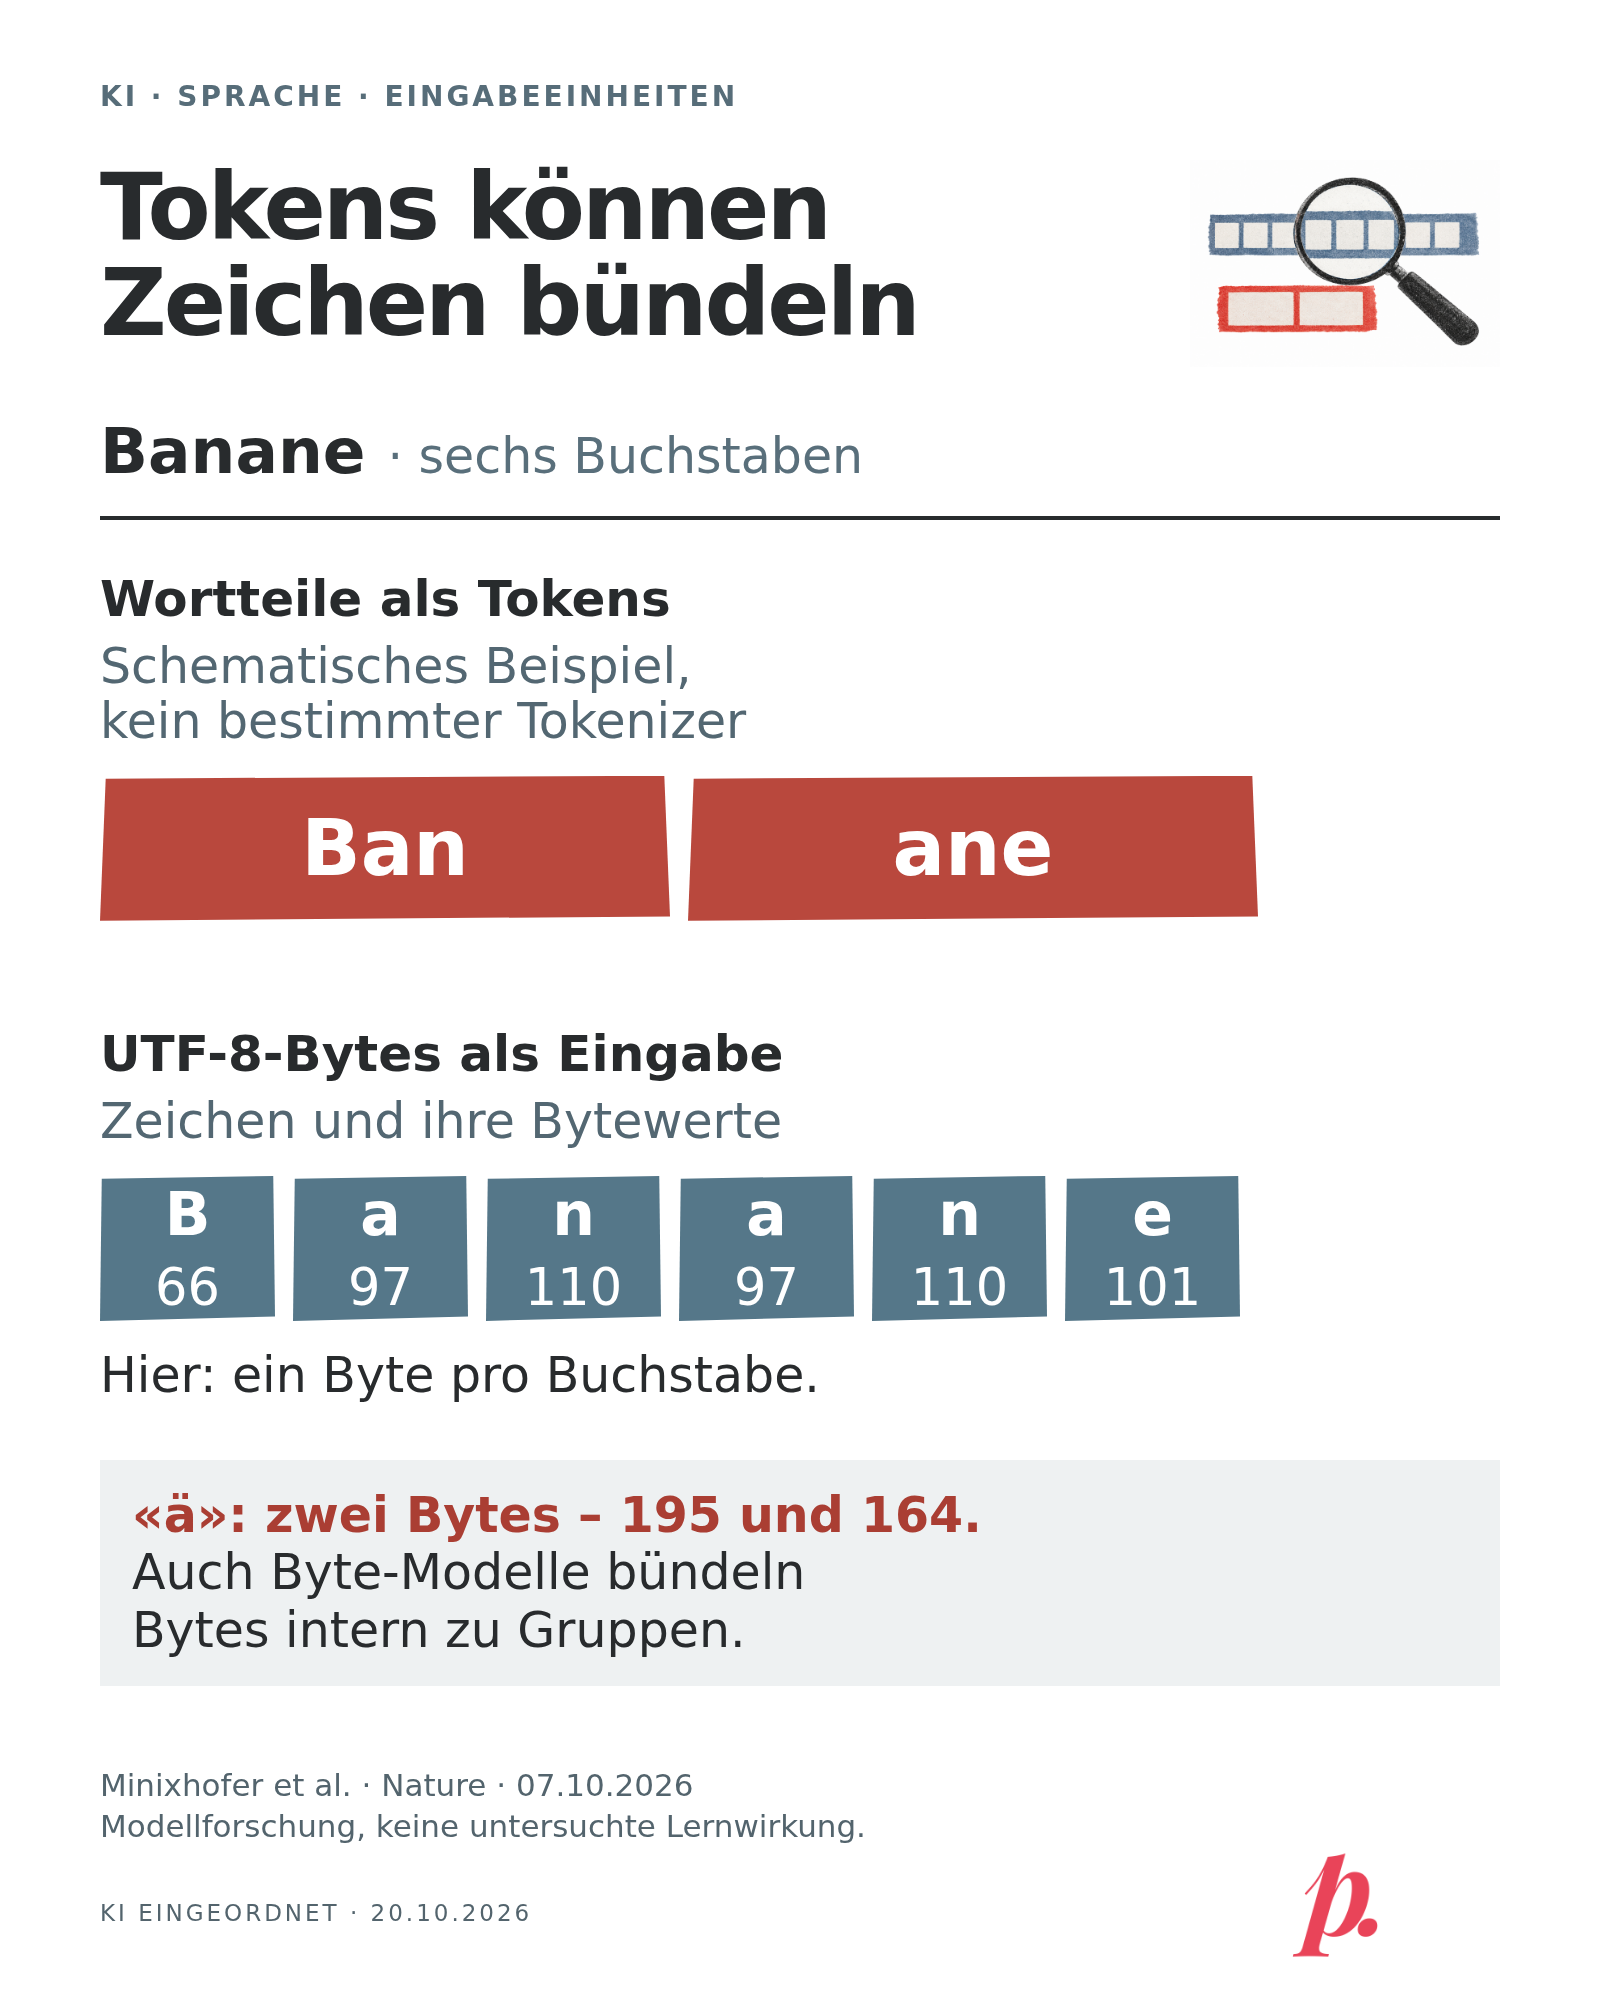
Die Grafik zeigt das Prinzip an «Banane». Die Aufteilung in zwei Wortteile ist bewusst schematisch, kein Ergebnis eines bestimmten Tokenizers. Bei den Bytes lässt sich dagegen exakt nachrechnen: Jeder dieser sechs Buchstaben braucht in UTF-8 ein Byte. Das gilt nicht für jedes Zeichen – «ä» braucht zwei.
Für den Unterricht heisst das: Sprachgefühl, Buchstabieren und Zählen nicht in einen Topf werfen. Wenn es auf jedes Zeichen ankommt, das Ergebnis direkt prüfen. Die Studie untersucht Modelltechnik, keine Lernwirkung.
Quellen & Recherchestand
Recherchiert: 2026-10-20
- Retrofitting language models to operate over bytes
Veröffentlicht: 2026-10-07 · Erhebung: nicht angegeben