Wenn KI-Noten näher liegen: Was Kalibrierung wirklich zeigt
In diesem Beitrag
Eine neue Studie bringt KI-Bewertungen näher an die Noten einer Lehrperson. Warum die Anpassung an denselben 40 Berichten noch wenig über neue Arbeiten und tragfähige Notenentscheidungen sagt.
Wenn ein Sprachmodell ähnliche Noten vergibt wie eine Lehrperson, klingt das nach Entlastung beim Korrigieren. Für den Unterricht zählt aber, ob die Bewertung fachlich trägt und auch bei der nächsten Arbeit verlässlich bleibt. Eine neue Studie liefert einen interessanten Befund zur Abstimmung von KI und Lehrperson. Ihre Anlage begrenzt zugleich, was sich daraus für die Benotung ableiten lässt.
Was nach der Anpassung besser passte
Die am 18. November 2026 veröffentlichte Untersuchung von Deepshikha und Navpreet Singh verglich GPT-5 mit den bereits vergebenen Bewertungen einer Lehrperson. Grundlage waren 40 Laborberichte aus einem Mastermodul zu elektrochemischen Energiespeichersystemen. Nach einer gemeinsamen Überarbeitung von Bewertungsraster und Prompt stieg das Übereinstimmungsmass ICC(2,1) von 0,818 auf 0,928. Das beschreibt eine stärkere Übereinstimmung innerhalb dieser Stichprobe; es ist keine Prozentangabe für richtige Noten. Originalstudie, Abstract und Ergebnisse.
Die entscheidende Einschränkung steht bereits im Studiendesign: Die Forschenden betrachteten zunächst die Abweichungen bei diesen 40 Berichten, passten daran ihre Vorgaben an und bewerteten anschliessend dieselben Berichte erneut. Ein davon getrennter Testsatz fehlte. Weil Rubrik und Prompt gleichzeitig verändert wurden, lässt sich ihr jeweiliger Beitrag nicht bestimmen. Zudem gab es keine zweite unabhängige menschliche Bewertung. Originalstudie, Abschnitte 2.1 und 4.4.
Übereinstimmung braucht einen Massstab
Für die pädagogische Einordnung sind drei Fragen zu unterscheiden: Passt die KI-Bewertung zur Referenz? Bilden die Kriterien das angestrebte Können ab? Trägt die Bewertung eine Entscheidung über Bestehen oder Nichtbestehen? Die Grafik verdichtet diese Unterscheidung. Sie ist eine Einordnung der Befundgrenzen, kein zusätzlicher Studienbefund.
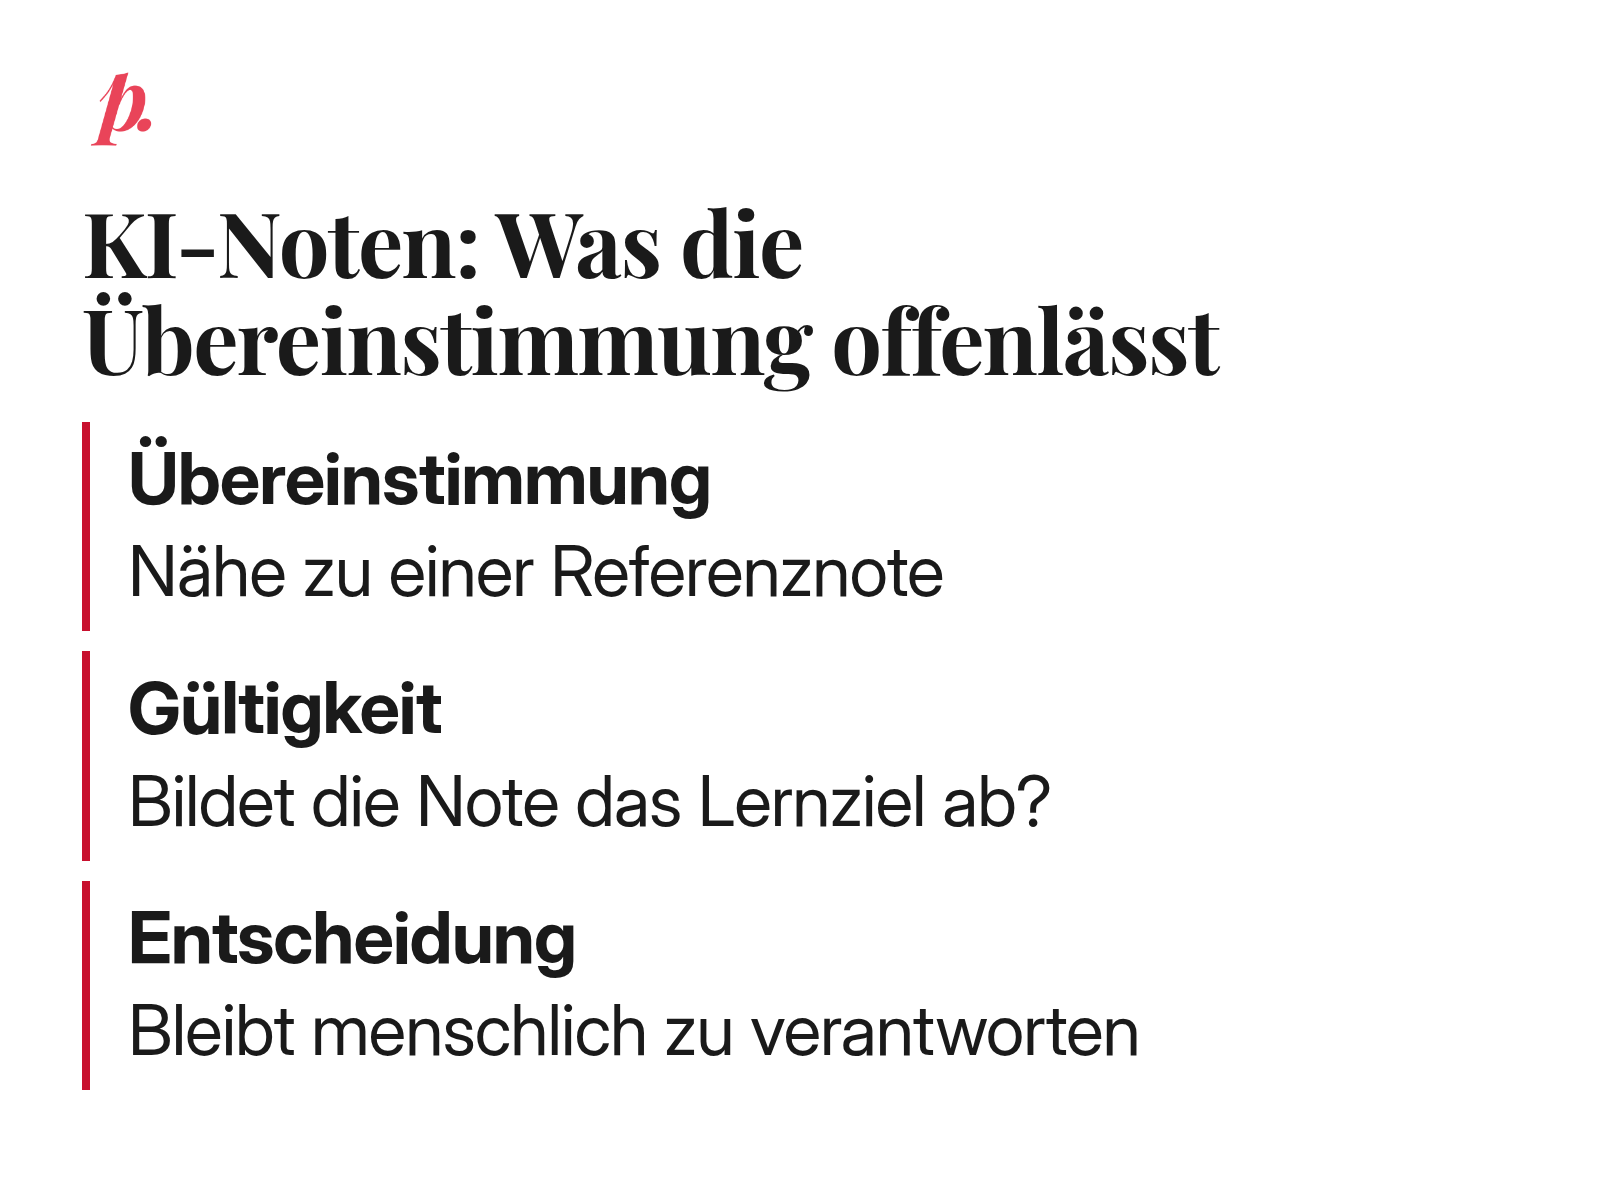
Eine Referenznote ist zunächst der gewählte Vergleichsmassstab. Ihre Nähe zur KI-Note sagt für sich allein wenig darüber, ob beispielsweise fachliches Verständnis, saubere Argumentation oder bloss eine überzeugende Darstellung honoriert wurde. Auch ein präzise formuliertes Raster braucht deshalb eine fachliche Begründung: Welche Leistung soll sichtbar werden, und woran lässt sie sich in dieser Aufgabe erkennen?
Die bestehende Kurz-Einordnung «KI prüft Feedback. Mit zwei Aufträgen.» in der Infografikenübersicht beschreibt ein verwandtes Problem: Eine Begründung kann zur Note passen und dennoch an der Arbeit vorbeigehen. Hier kommt die Frage hinzu, wie belastbar eine Anpassung ist, wenn ihre Prüfung an denselben Beispielen erfolgt. Für die Praxis wäre besonders aufschlussreich, wie das festgelegte Verfahren mit bisher ungesehenen Arbeiten umgeht.
Andere Aufgaben können ein anderes Bild ergeben
Eine unabhängige Untersuchung von Zacharis und Papadakis betrachtete 91 Essays aus Lehramtsstudiengängen an zwei griechischen Universitäten. Zwei Menschen und ein KI-System bewerteten sie mit derselben Rubrik. Die menschlichen Bewertungen stimmten deutlich stärker miteinander überein als jeweils mit der KI. Diese vergab im Mittel höhere Punktzahlen und stauchte die Verteilung; schwächere Arbeiten wurden eher über-, stärkere eher unterbewertet. Vergleichsstudie, Abstract und Ergebnisse.
Das ist keine Widerlegung der neuen Laborbericht-Studie: Aufgaben, Systeme und Fachkontexte unterscheiden sich. Es zeigt jedoch, weshalb ein guter Gesamtwert als einzige Entscheidungsgrundlage zu schmal wäre. Für ein Kollegium wäre zusätzlich relevant, bei welchen Leistungsniveaus Abweichungen auftreten und ob sie an einer Bestehensgrenze Folgen haben. Beide Untersuchungen betreffen Hochschulen. Für jüngere Schülerinnen und Schüler liefern sie keinen direkten Nachweis.
Was daraus für einen schulischen Pilotversuch folgt
Als redaktionelle Schlussfolgerung bietet sich ein begrenzter Pilot an, in dem KI zunächst Bewertungsvorschläge liefert. Fachlich begründete Kriterien müssten vor der Erprobung feststehen. Die Arbeiten zur Anpassung und jene zur anschliessenden Prüfung sollten getrennt bleiben; für die Prüfung wäre eine unabhängige menschliche Zweitbeurteilung hilfreich. Zu betrachten wären neben der Gesamtnähe auch einzelne strittige Fälle und Unterschiede entlang des Leistungsniveaus. Dieser Vorschlag ist keine durch die neue Studie geprüfte Intervention.
Ebenso wichtig bleibt die Aufgabe selbst. Eine systematische Übersicht von Crompton und Burke ordnet KI-Bewertung als Unterstützung professionellen Urteils ein. Sie beschreibt gestufte Aufgaben, Dokumentation und Reflexion als Wege, Lernprozesse sichtbar zu machen. Übersicht, «Grading» und «Transparency of learning».
Daraus folgt für die Unterrichtsplanung: Wer Verständnis beurteilen will, könnte neben dem fertigen Produkt beispielsweise einen begründeten Zwischenschritt oder ein kurzes Fachgespräch berücksichtigen. Welche Form passt, hängt vom Lernziel ab. Eine genauere Punktezuordnung allein beantwortet diese didaktische Frage nicht. Der Nutzen einer KI-Unterstützung wäre deshalb daran zu messen, ob Lehrpersonen ihre Bewertung besser prüfen und erklären können. Über eine folgenreiche Note sollten sie weiterhin selbst entscheiden.